ChatGPTやClaudeは、毎日のように私たちの質問に答えてくれます。それなのに、作った会社でさえ「AIの頭の中で何が起きているのか」をほとんど説明できない。この不思議な状態は「AIのブラックボックス問題」と呼ばれ、長年の難題でした。
そのブラックボックスに、大きな光が差し込もうとしています。2026年10月15日、OpenAIで解釈可能性の研究をしていたニック・カマラタ氏が、エッセイ「Neural Networks Are Already Clean(ニューラルネットワークはすでにきれいだ)」を公開しました。「AIの中身はぐちゃぐちゃではなく、正しい道具で見れば大部分が読める」という主張に、世界のAI研究者が一斉に反応しています。この記事では、エッセイの中身と世界の反応、そしてあなたのAIの使い方に何が変わるのかを、図と実演で分かりやすく解説します。
カマラタ氏は、AIのニューロン(中の小さな部品)の多くは、1つの意味を持つ「きれいな」部品だったと主張しています。2023年には約1.7%しか説明できなかったニューロンが、最新の道具を使った予備調査では約90%が1つの主な役割を持つと見積もられました。
ただし本人もこのエッセイを「作業仮説」と位置づけており、詳しい技術論文はこれから公開されます。期待と慎重論の両方を知ったうえで、AIの安全につながる大きな一歩として注目する価値があります。
01「作った会社にも中身が分からない」AIの謎
家電や車なら、設計した人が部品ひとつひとつの役割を説明できます。ところがAIは事情が違います。今のAIは、人が1行ずつプログラムを書いて作るのではなく、膨大な文章や画像を読ませて、AI自身に中の設定を少しずつ調整させる「学習」で作られます。
そのため、完成したAIの中には何十億もの数字が並んでいて、どの数字がどんな意味を持つのかは、AIが学習の中で自分で決めています。性能は高いのに、なぜその答えを出したのかを説明できない。これがブラックボックス問題です。
この問題は、AIが病院や銀行、学校で使われるほど重くなります。AIが正直に答えているのか、どこかで間違った覚え方をしていないのかを、外から確かめるしかないからです。この難題に挑む研究分野は「解釈可能性(インタープリタビリティ)」と呼ばれ、AnthropicやOpenAI、Google DeepMindなどが力を入れています。
02ブラックボックスとは:ニューロンの仕組みを図解
ChatGPTやClaudeの中身は「ニューラルネットワーク」と呼ばれる仕組みです。脳の神経細胞をまねた「ニューロン」という小さな部品が、何層にも重なってできています。あなたが質問を入力すると、その情報が層から層へ伝わり、最後に答えが出てきます。
「猫の写真」など
少しずつ反応して信号を渡す
「これは猫です」
問題は、真ん中の箱です。ニューロンの反応は数字で記録されるだけで、「このニューロンは猫を見ている」といったラベルは、人が後から見つけるものです。研究者は、どんな画像や言葉に強く反応するかを調べて、ひとつひとつの役割を推理するという地道な方法を取ってきました。
長年の定説:「1つのニューロンが、無関係な意味をいくつも持つ」
研究が進むと、困った事実が見つかりました。多くのニューロンが、まったく関係のない複数のものに反応していたのです。代表例が、画像認識AI「InceptionV1」の4e:55という番号のニューロンで、猫の顔にも、車の正面にも反応していました。
- ニューロンの数より、世の中の概念のほうがずっと多い
- だからAIは、無関係な概念を同じニューロンに詰め込んでいる
- ニューロンを直接見ても意味は分からない
- 別のAI(辞書のような道具)で、もつれをほどく必要がある
- 多くのニューロンは、もともと1つの意味を持つ
- 無関係に見えた反応は、関連する概念へ少しずつ枝分かれした結果
- 見えにくかった原因は、道具の弱さや古い設計など、直せる問題
- ニューロンそのものを丁寧に読めば、大部分を理解できる
03発表の概要:元OpenAI研究者が出した「うれしい知らせ」
エッセイを書いたニック・カマラタ氏は、OpenAIの解釈可能性チームの初期メンバーです。2020年には、この分野の第一人者クリス・オラ氏らと論文「Zoom In」を共著し、2023年にはOpenAIで「AIに別のAIの部品を説明させる」研究を立ち上げました。現在は、AIの中身の解明に特化した研究企業Goodfire(グッドファイア)に所属しています。Goodfireは2026年2月に、評価額12.5億ドルで1億5,000万ドルの資金調達を発表しています。
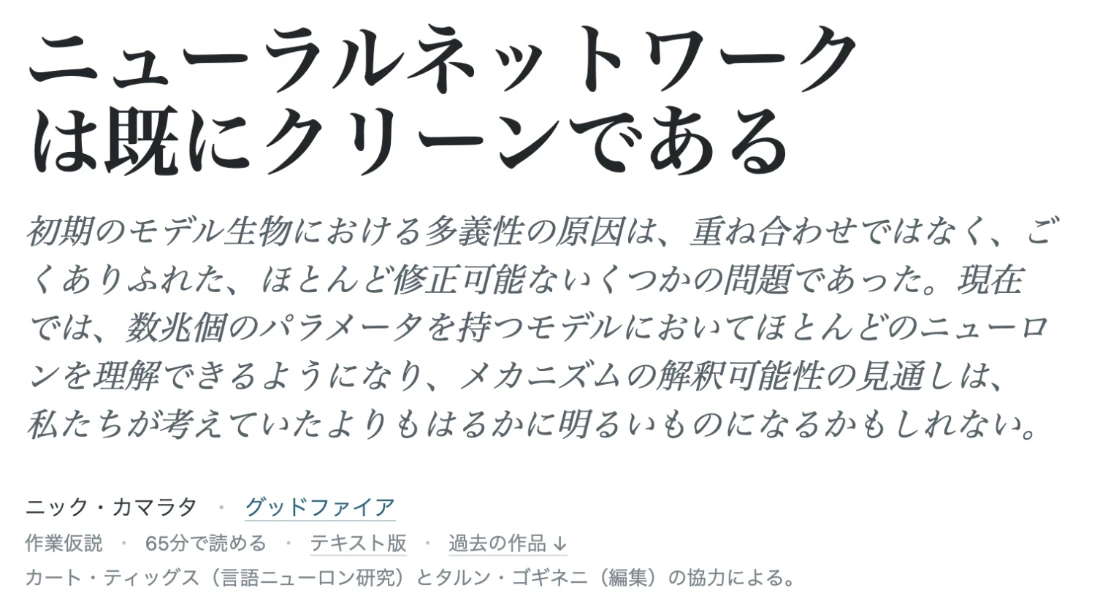
- これまで「1つのニューロンが多くの意味を持つ」とされた原因は、概念の詰め込みではなく、ありふれた、ほとんど直せる問題だった。
- 今では、数兆個のパラメータを持つモデルでも、大半のニューロンを理解できるようになった。
- AIの仕組みを解き明かす研究の見通しは、考えられていたよりずっと明るい。
- 本人は「作業仮説」と明記。言語ニューロンの研究はカート・ティッグス氏が協力した。
中でも大きな注目を集めたのが、言語モデルでの数字です。エッセイによると、2023年当時、Anthropicの研究「Towards Monosemanticity」では小さなモデルの代表的なニューロンが14点満点中0点(評価者が仮説を立てられない状態)と評価され、カマラタ氏がOpenAIで始めた研究でも、最も甘い基準で説明できたのは約1.7%でした。
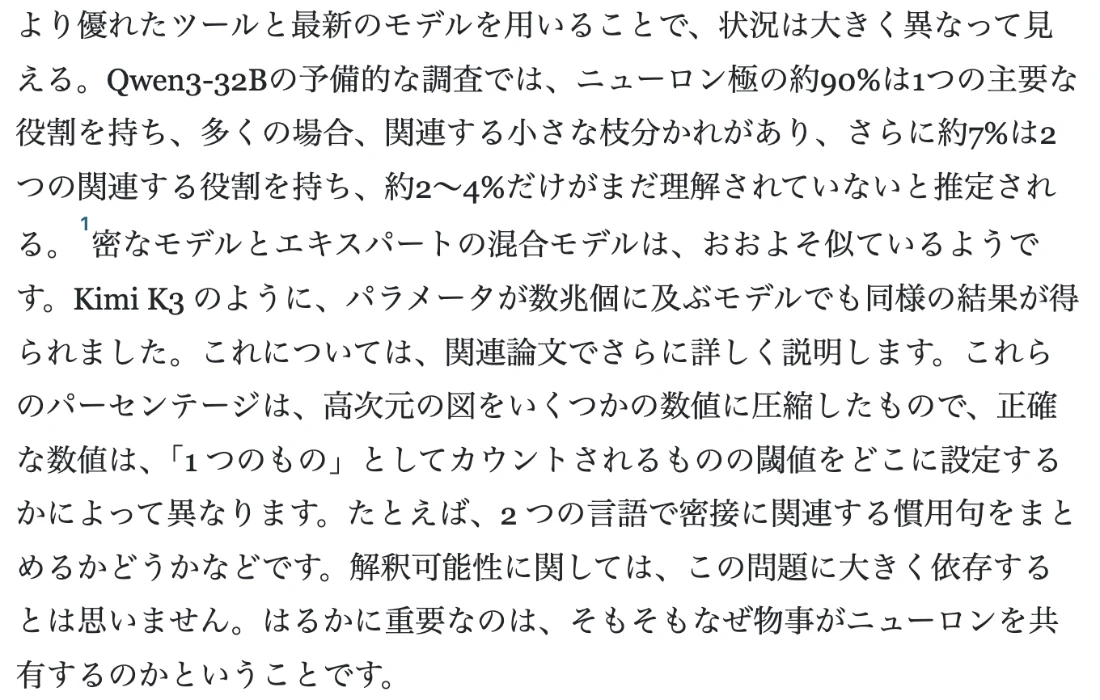
エッセイによると、同じような結果はKimi K3のように数兆個のパラメータを持つモデルでも得られ、詳しくは今後公開される関連論文で説明されます(エッセイの言語モデルの章)。小さなモデルで0点だった時代から、巨大なモデルの9割を読める時代へ。この変化の大きさが、世界の研究者を驚かせました。
04「猫と車」のニューロンは、実は「V字」を見ていた
エッセイの中で最も印象的なのが、有名な「猫と車のニューロン」の読み直しです。このニューロンは、2017年の特徴の可視化の研究や2020年の「Zoom In」など、分野を代表する論文で「1つのニューロンが無関係な意味を持つ」例として何度も取り上げられてきました。
カマラタ氏は、何百回も見てきた画像の一覧を開き、初めて「これは1つの何なのか」を数秒考えました。答えは「V字の形」でした。耳とあごがとがった猫の顔も、ボンネットとグリルが前に向かってとがる車の正面も、どちらもV字を描いています。
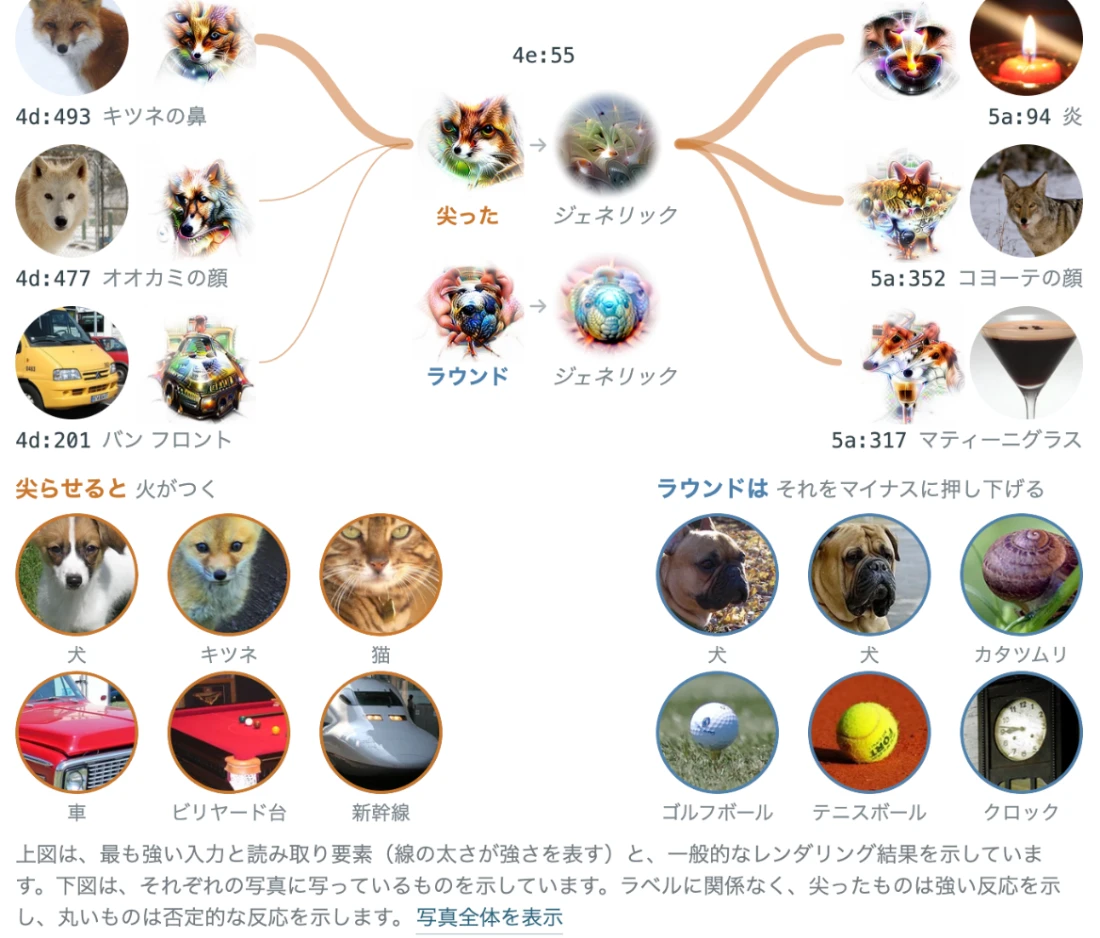
- 左側:このニューロンに信号を送るのは「キツネの鼻」「オオカミの顔」「バンの正面」。どれもとがった形です。
- 右側:このニューロンの信号を受け取るのは「炎」「コヨーテの顔」「マティーニグラス」。これらもV字形です。
- 下の段:犬・猫・車・新幹線など、とがったものは強く反応させ(オレンジ)、ゴルフボールや時計など丸いものは反応を下げます(青)。
決め手は、反対側の反応でした。このニューロンを最も強く打ち消すのは、V字のとがった部分がちょうど丸くなった「O字」の形です。反対側が丸になるのは、このニューロンが「とがった形」を見ているからこそです。V字を見分ける部品だと考えると、すべてが一本の線でつながります。
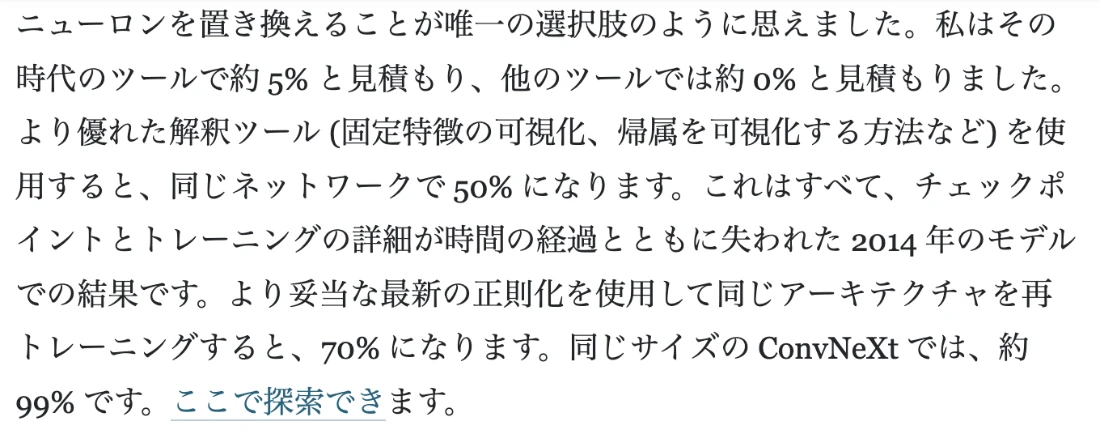
エッセイによると、この画像AI(2014年のモデル)の最後の層は、当時の道具では意味が読み取れるニューロンが約5%と見積もられていました。より良い道具を使うと約50%、今の学習方法で作り直すと約70%、同じ大きさの新しい設計(ConvNeXt)では約99%になります。
05木の枝のように育つニューロン
では、なぜ「無関係な寄せ集め」に見えたのでしょうか。カマラタ氏は、画像AIを最初から学習し直し、ひとつのニューロンが育っていく様子を記録しました。その答えが「再帰的一般化」、つまりニューロンが、関連するものへ一歩ずつ枝を伸ばしていくという現象です。
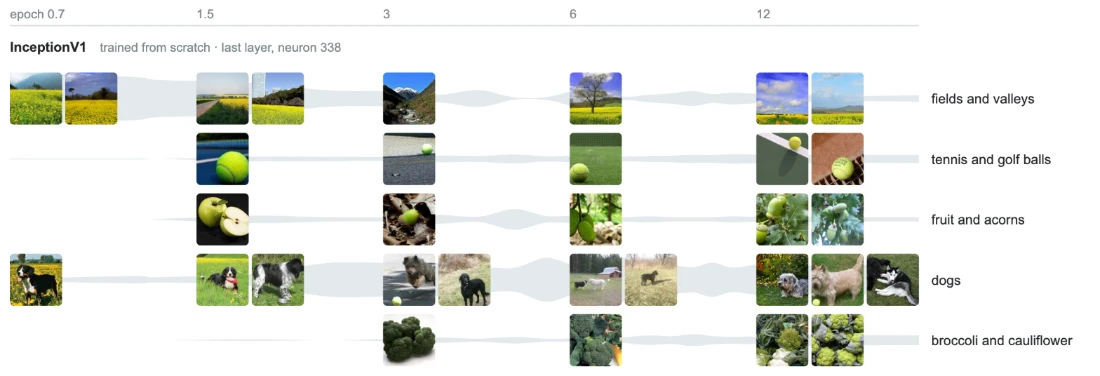
完成したニューロンだけを見ると「テニスボール、犬、ブロッコリー」というバラバラな組み合わせです。しかし育つ過程を追うと、一歩ずつは、どれも前の段階とつながっています。家系図や植物の枝分かれのように、関連から関連へ広がっていたのです。
言葉のAIでも同じ:「iy」から「do it yourself」へ
同じことは、ChatGPTやClaudeのような言葉のAIでも起きていました。ある言語モデルのニューロンは、最初「Miyazaki(宮崎)」に含まれる「iy」という文字の並びに反応し、次に「diy」、さらに「do it yourself」へと広がりました。最後の「do it yourself」は、もう「iy」を含まない言葉です。
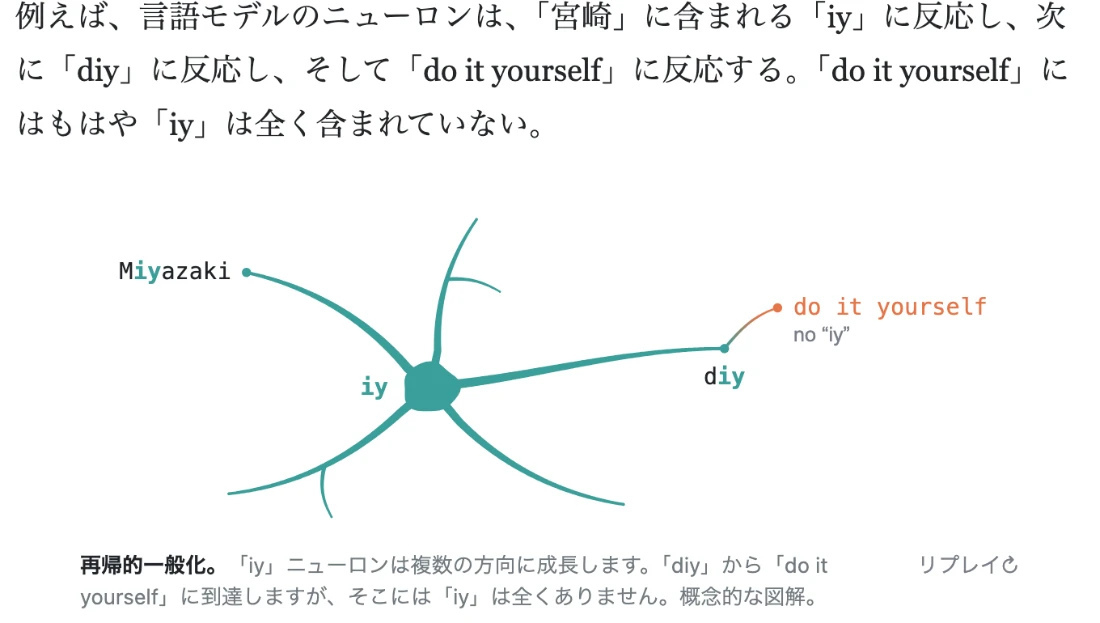
エッセイには、ほかにも面白い例が紹介されています。
06Anthropicのこれまでの研究:中身を見て動きを変えた「Golden Gate Claude」
「AIの中身を読めば、AIの動きを変えられる」。これを世界に分かりやすく示したのが、Claudeを開発するAnthropicです。2024年5月23日、Anthropicは研究デモ「Golden Gate Claude(ゴールデンゲート・クロード)」を公開しました。
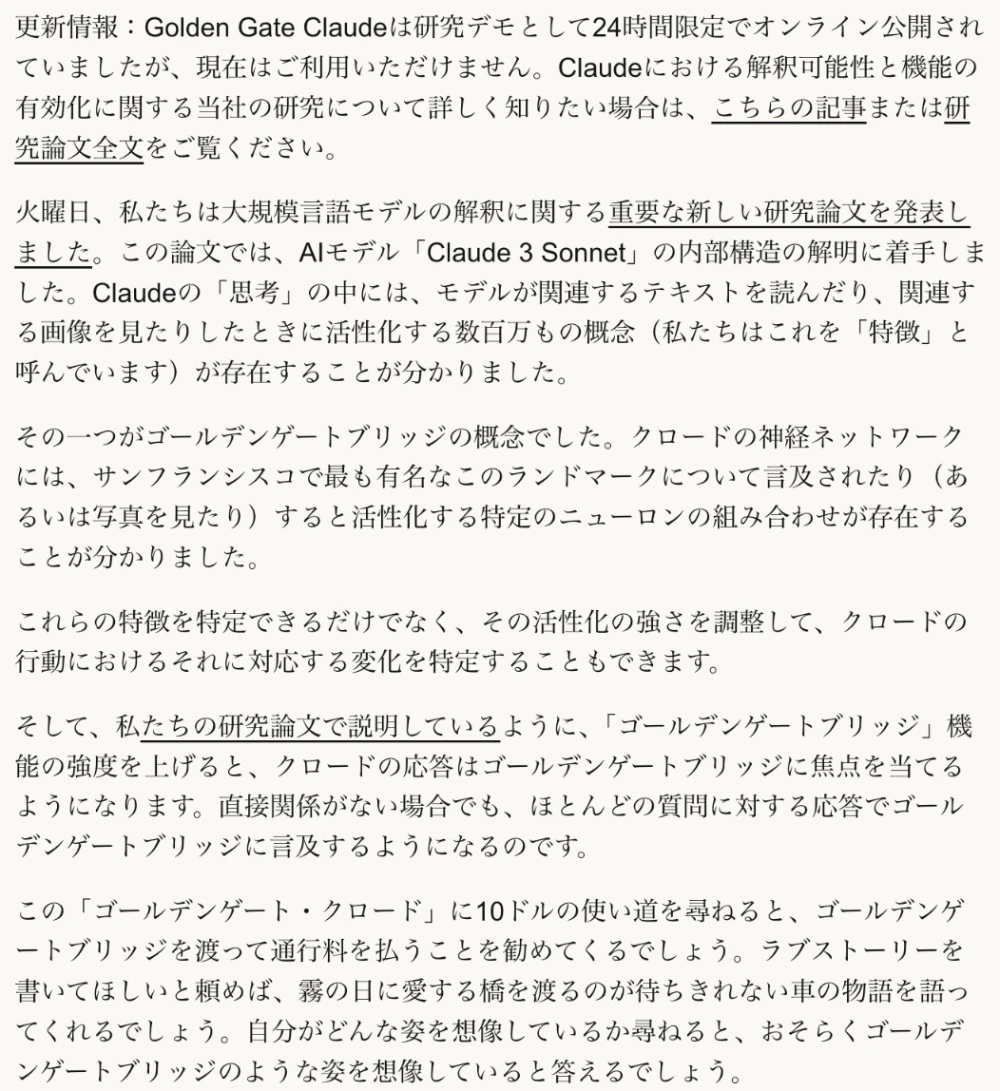
Anthropicは、論文「Scaling Monosemanticity」で、Claude 3 Sonnetの中に「ゴールデンゲートブリッジ」に反応する特徴(ニューロンの組み合わせ)を見つけ、その強さを人工的に上げました。するとClaudeは、関係のない質問にも橋の話をするようになり、「10ドルの使い道は?」と聞かれると「橋を渡って通行料を払う」ことを勧めたのです。このデモは24時間限定で公開されました。
Golden Gate Claudeは、AIの中の部品を直接調整して、話題の選び方まで変えた実例です。今回のエッセイのコロラドのニューロンも、同じ考え方です。将来、「うそ」や「お世辞」に関わる部品を見つけられれば、AIを内側から点検し、直せるようになります。
Anthropicはその後も研究を進め、2026年7月には、Claudeの中に考えを集めて整理する場所「Jスペース」を見つけたと発表しています(解説記事)。AIを「外から試す」時代から、「中を見て確かめる」時代へ。今回のエッセイは、その流れを大きく後押しするものです。
07世界の反応:期待と慎重論
エッセイは公開直後から、AI業界で大きな話題になりました。ドイツのAI専門メディアThe Decoderは、「研究者の意見が割れている」と報じています。
| 立場 | だれが | 主な声 |
|---|---|---|
| 期待 | Roon氏(OpenAIの研究者、Xでの名前) 出典:The Decoder |
「科学史に残る大きな瞬間」と評価。AIによる破滅を心配する人も、その見込みを下げざるを得ないだろうと投稿した |
| 期待 | カマラタ氏本人 出典:The Decoder |
自動化されたAI研究者を使えば、人が画像AIで10年近くかけたことを数か月で進められると考えている |
| 慎重 | ニール・ナンダ氏(Google DeepMind 解釈可能性チームの責任者) 出典:The Decoder |
興味深い研究だが、大きな全体像は変わらないと指摘。重ね合わせは実在すると考え、「1つの意味」の定義がゆるいと評価した |
| 慎重 | エッセイ自身 出典:Goodfire |
「作業仮説」と明記。数字は基準で変わり、詳しい技術論文はこれから公開。外部の研究者による再現は、これからの課題 |
ナンダ氏も、カマラタ氏が自分の過去の研究を最新の道具で見直したことは高く評価しています。期待する側も慎重な側も、「AIの中身を読む研究が、新しい段階に入った」という点では一致していると言えます。
08実演:ClaudeとChatGPTに「ブラックボックス」を説明してもらった
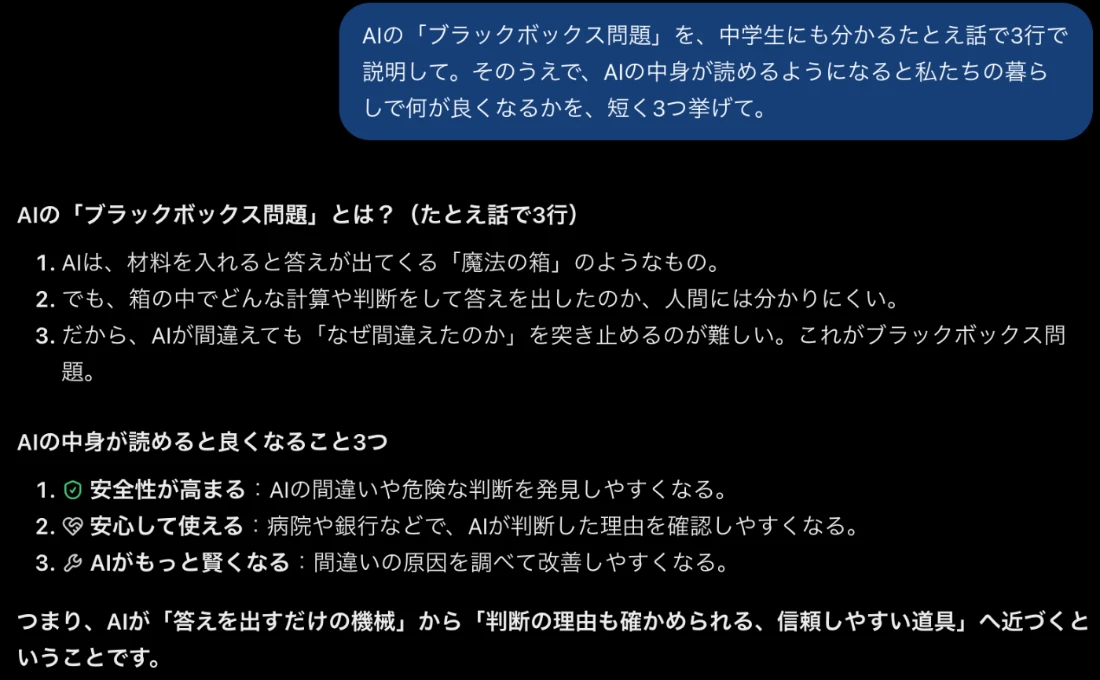
ブラックボックス問題は、言葉で説明するのが難しいテーマです。そこで、ClaudeとChatGPTに同じ質問をして、説明の仕方を比べてみました。
「AIの『ブラックボックス問題』を、中学生にも分かるたとえ話で3行で説明して。そのうえで、AIの中身が読めるようになると私たちの暮らしで何が良くなるかを、短く3つ挙げて。」
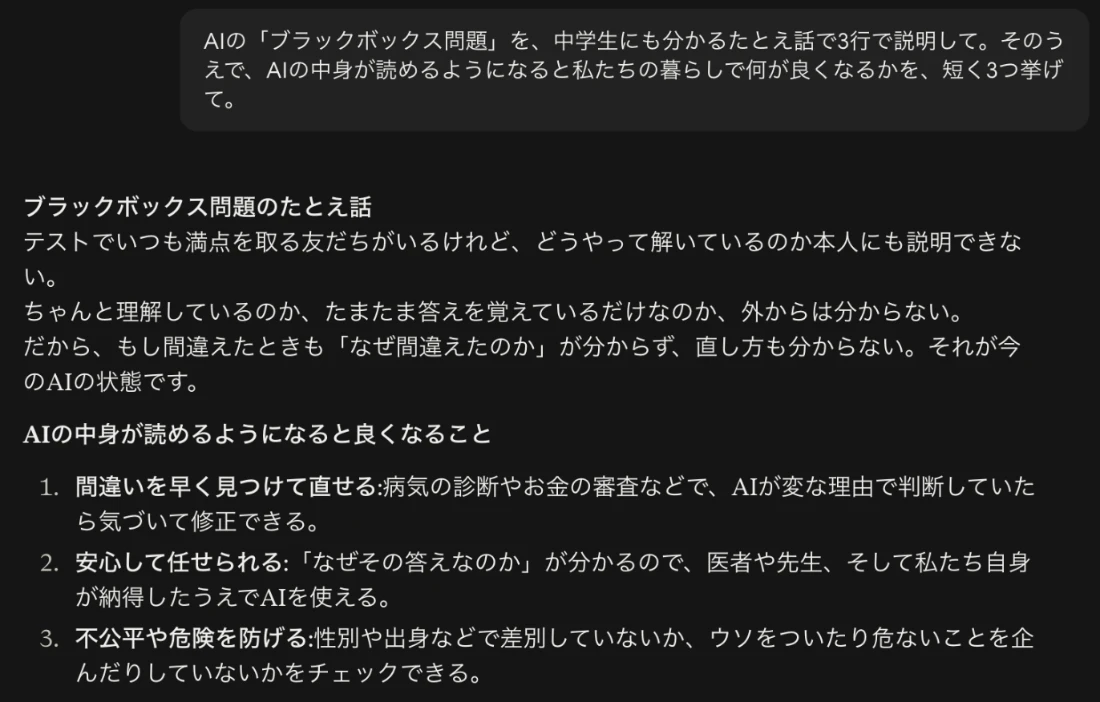
- 「満点なのに解き方を説明できない友だち」にたとえた
- 「理解しているのか、暗記なのか分からない」という核心に触れた
- 3つめに「ウソや危ないことを企んでいないか」の点検を挙げた
- 「材料を入れると答えが出る魔法の箱」にたとえた
- アイコン付きの見出しで、ひと目で読める形に整えた
- 最後に「信頼しやすい道具へ近づく」と一文でまとめた
どちらも正確で分かりやすい説明です。ChatGPTは要点を短く整理する力、Claudeは身近な場面に置きかえて核心を伝える力が光りました。特にClaudeが3つめに挙げた「ウソや危ないことを企んでいないかのチェック」は、解釈可能性の研究が目指すゴールそのものです。
09あなたのAIの使い方に何が変わるか
中身を読む研究が進むと、AIを使う私たちにも直接のメリットがあります。研究者が特に目指しているのは、次の3つを内側から見つける技術です。
- 大事な答えには「根拠を示して」「自信がない部分はどこ?」と聞き返す。
- 健康やお金の判断は、公式の情報や専門家で確かめる。
- ChatGPTとClaudeの2つに同じ質問をして見比べると、答えの偏りに気づきやすくなります。
10AIのプロの見解:AIを「読む」研究が安全の土台になる
私たちAQUAは、日々ChatGPTやClaudeを業務に使う立場から、今回のエッセイを「AIを安心して任せるための、いちばん地道で大切な研究」の前進と受け止めています。
一方で、エッセイ自身が「作業仮説」と書いているとおり、他の研究者による検証はこれからです。結論を急がず、技術論文の公開と再現の結果を見守る姿勢が大切です。大きな発見ほど、慎重な確認を経て本物になります。
それでも、「猫と車」が「V字」だったという発見は、AIの中身が想像よりずっと人間に読みやすい形をしている可能性を示しました。AIを読む力が、AIを安全に使う力になる。この流れが続けば、ブラックボックスは少しずつ「ガラスの箱」に変わっていくはずです。
11よくある質問
12まとめ
- 2026年10月15日、ニック・カマラタ氏がエッセイを公開。「AIのニューロンの多くは、もともときれいに読める」と主張しました。
- 「猫と車のニューロン」は「V字」のニューロンだった。反対側が丸いO字であることが決め手になりました。
- ニューロンは木の枝のように育つ。関連から関連へ広がるため、完成形だけを見るとバラバラに見えていました。
- 言語モデルでも約90%が1つの主な役割。2023年の約1.7%から大きく前進しましたが、数字は予備調査で、本人も「作業仮説」としています。
- 中身を読めれば、AIを内側から点検・修正できる。Golden Gate Claudeはその実例で、うそや作り話を減らす技術につながります。
「作った会社にも分からない」と言われてきたAIの中身に、ようやく読み方が見えてきました。ChatGPTやClaudeを使うときに、その向こうで「AIを読む」研究が進んでいることを思い出してみてください。AIは、私たちが理解し、確かめながら付き合える存在へと近づいています。
13参考リンク
- Nick Cammarata(Goodfire)「Neural Networks Are Already Clean」(英語)
- Anthropic「Golden Gate Claude」(英語、2024年5月23日)
- Anthropic「Scaling Monosemanticity」(英語、2024年)
- The Decoder「Is AI interpretability close to a breakthrough? A new essay has researchers divided」(英語、2026年10月16日)
- Goodfire「Our Series B」(英語、2026年2月)
- Distill「Zoom In: An Introduction to Circuits」(英語、2020年)
- Distill「Feature Visualization」(英語、2017年)
- Anthropic「Towards Monosemanticity」(英語、2023年)
- OpenAI「Language models can explain neurons in language models」(英語、2023年5月9日)
- Anthropic「A global workspace in language models」(英語、2026年7月6日)
- Qwen「Qwen3-32B」(Hugging Face)
- Szegedy et al.「Going Deeper with Convolutions」(InceptionV1、2014年)
- Liu et al.「A ConvNet for the 2020s」(ConvNeXt、2022年)
- YouTube「Is This The Biggest AI Discovery Of The Year?」(TheAIGRID、英語)